本小节学习时长:19min
本节要点:
正片:
前面,我们了解了 ChatGPT 的大致原理,也熟悉了一些使用 ChatGPT 的技巧和经验。
相信你对 ChatGPT 的回答质量也有了 一定的理解和自己的评价判断。ChatGPT 的回答内容一般都比较客观、公正的,而且语言叙述平实,没有情感偏向,这是它的优势所在。
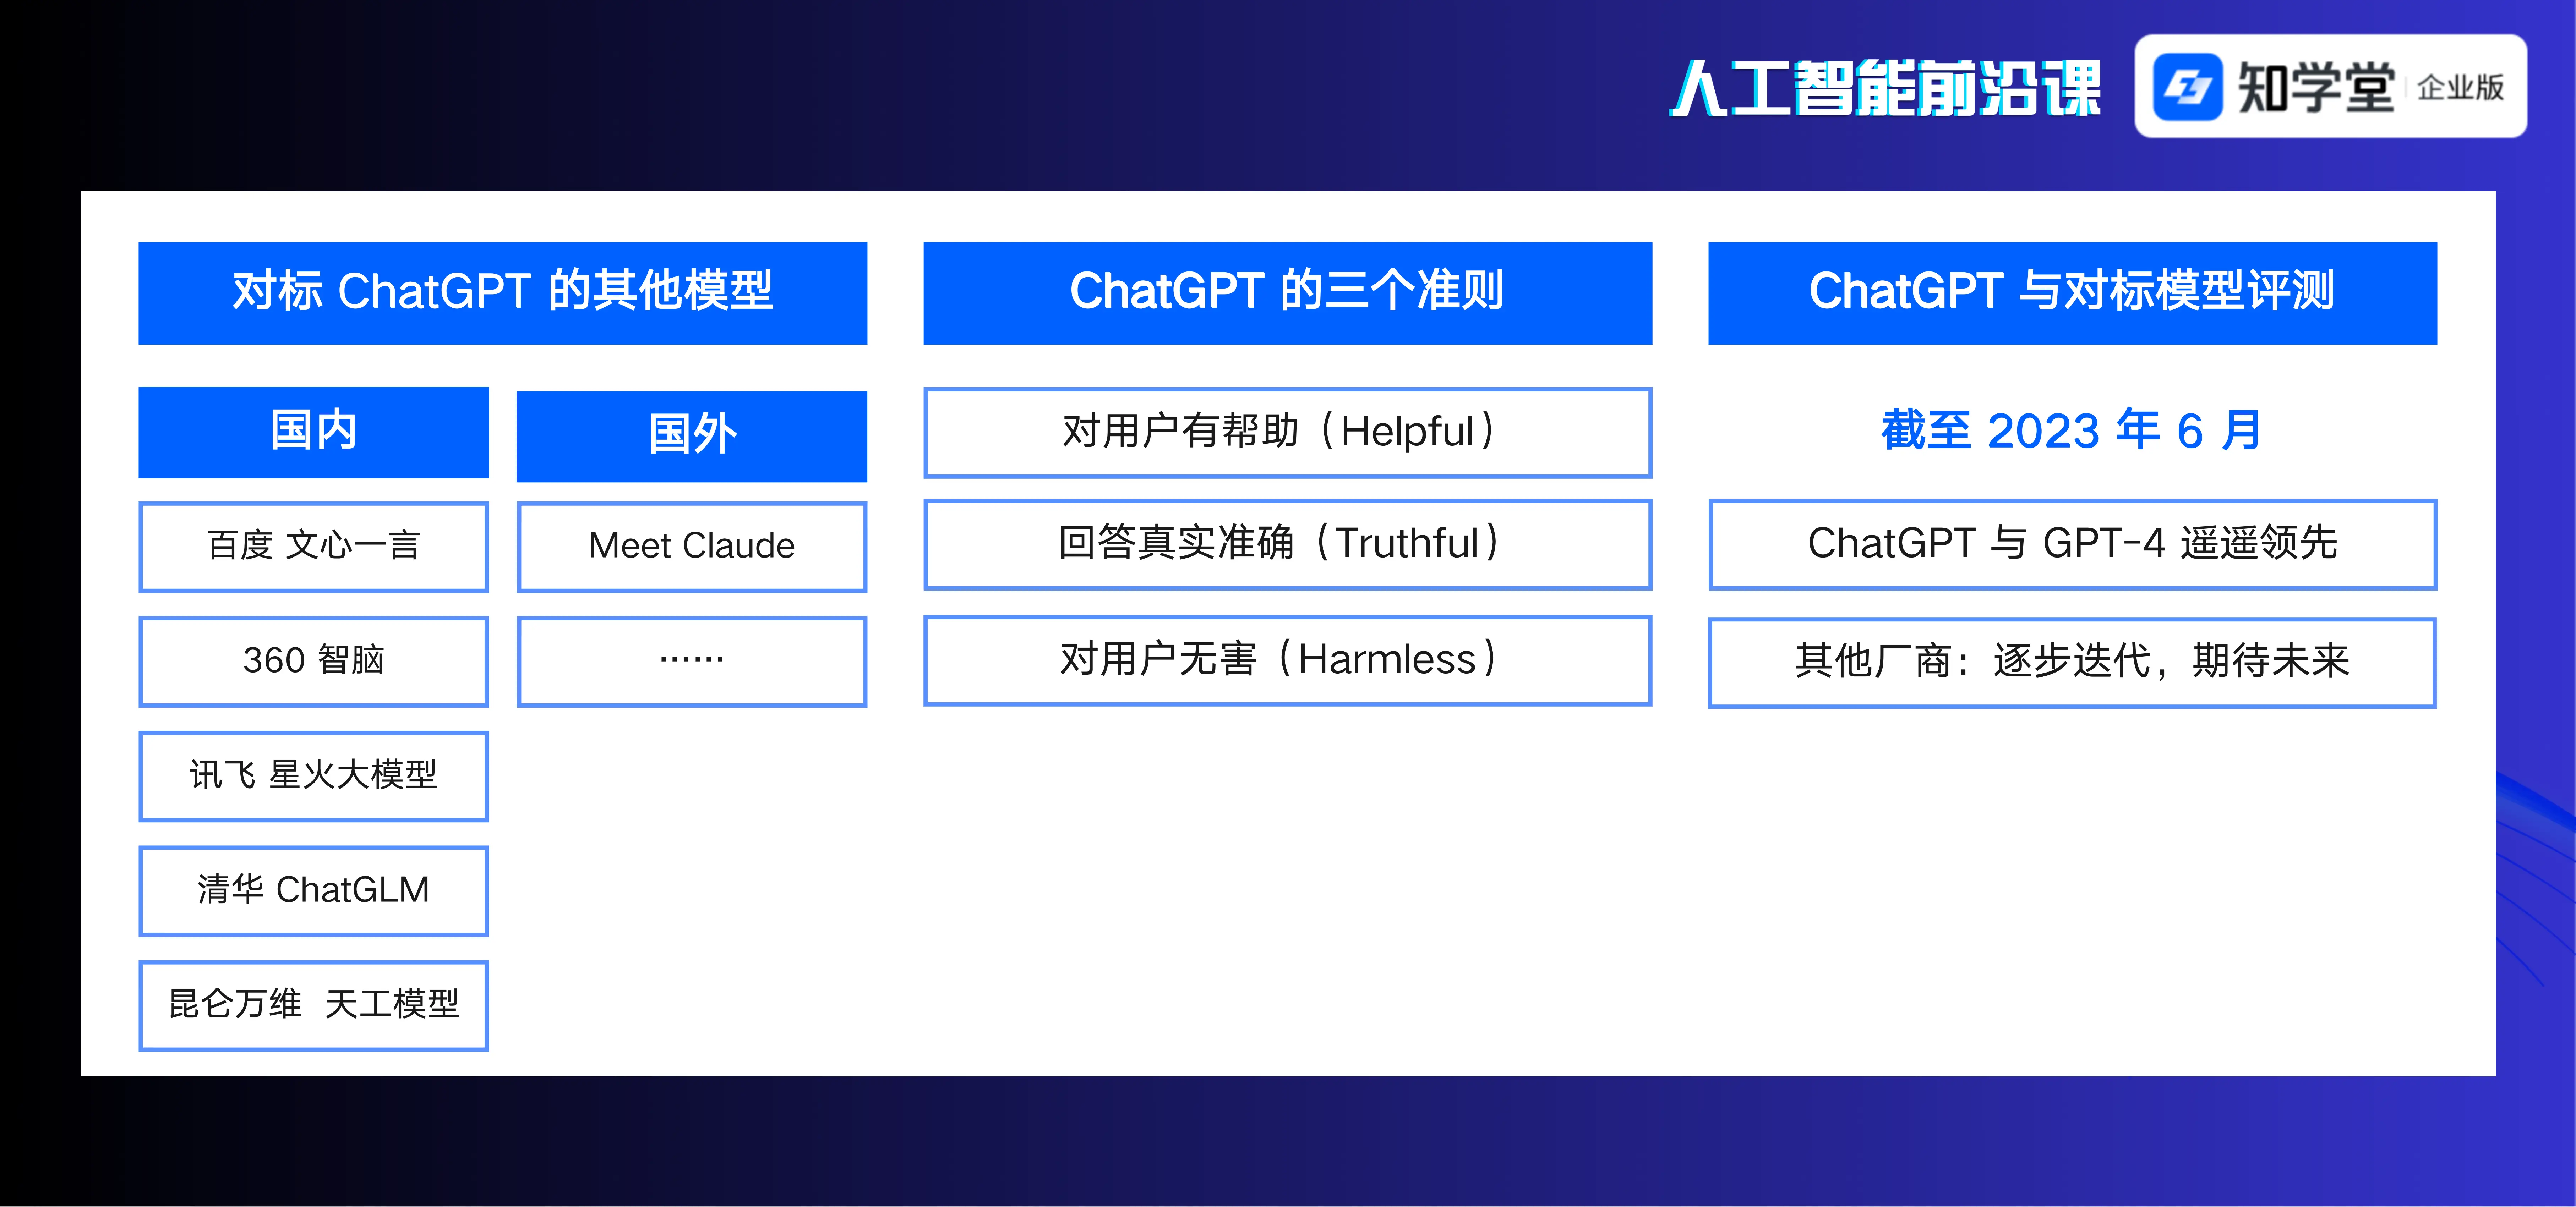
此外,国内外,也有很多对标 ChatGPT 的语言模型出现。
这一节,我将介绍一下,ChatGPT 的回答质量高在哪里?其它模型的真实水平,究竟是怎么样?以及如何对这些模型进行一个横向的比较和评测。
自从 ChatGPT 在 2022 年 11 月 30 号 诞生以来,有很多互联网巨头公司,也都在研发自己的对标 ChatGPT 的大语言模型,比如百度的文心一言,360 的 智脑大模型、清华的 GLM 模型,昆仑万维天工、阿里的通义千问。
同时,国外也有相应的模型,比如 claude 等等。
可能大众从新闻媒体上了解了很多信息,但是对于这些对标 ChatGPT 的模型究竟怎么样,仍然缺乏一定的了解。
因此,我们有必要来对当前数量众多的大语言模型建立一个清晰的认知。
这就需要涉及到 AI 与人类的关系的讨论。
(本章节未完结,点击下一页翻页继续阅读)


 正在加载...